पुराने फ़ॉन्ट की हिन्दी, यूनिकोड में: दो नमूने, नाप-तौल के साथ
कृतिदेव फ़ॉन्ट में टाइप की गई दो PDF, जिन्हें IndicPDF के Legacy PDF to Word टूल से और फिर Word to EPUB से गुज़ारा गया। नीचे हर मूल फ़ाइल की तस्वीर है, उससे कॉपी करने पर मिलने वाला टेक्स्ट है, यूनिकोड में निकला टेक्स्ट है, और हमारी गिनती है। मूल PDF भी डाउनलोड कर सकते हैं; Word और EPUB फ़ाइलें टूल का अपना आउटपुट हैं, बिना किसी सुधार के।
नमूना 1: किताब की तरह छपी एक कहानी
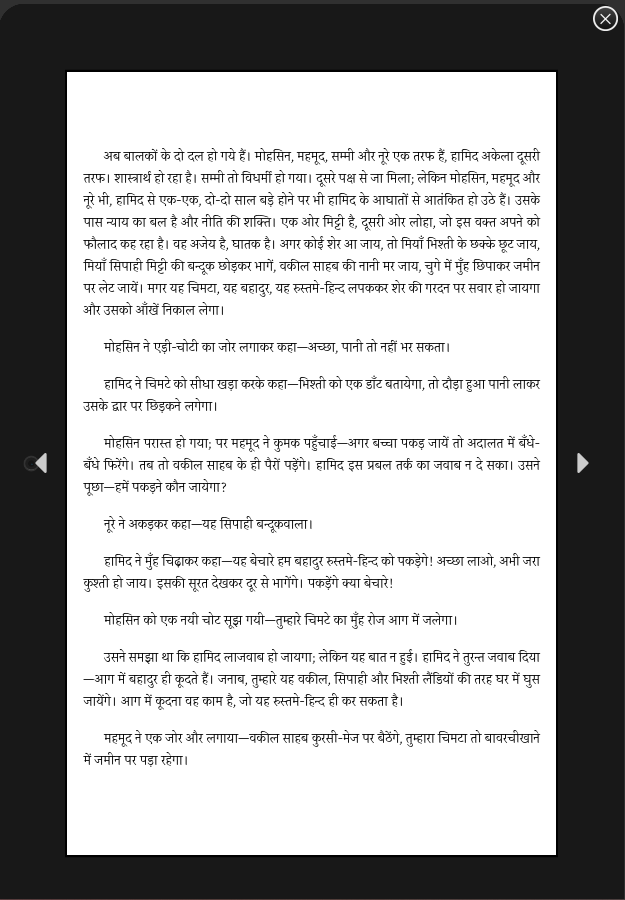
प्रेमचंद की कहानी ईदगाह, कृतिदेव 010 में 12 पेज की A5 किताब की तरह छापी गई — मुखपृष्ठ, अध्याय-शीर्षक, ऊपर का शीर्षक, पेज संख्या, एक पाद-टिप्पणी — और Microsoft Word से फ़ॉन्ट समेत PDF बनाई गई।
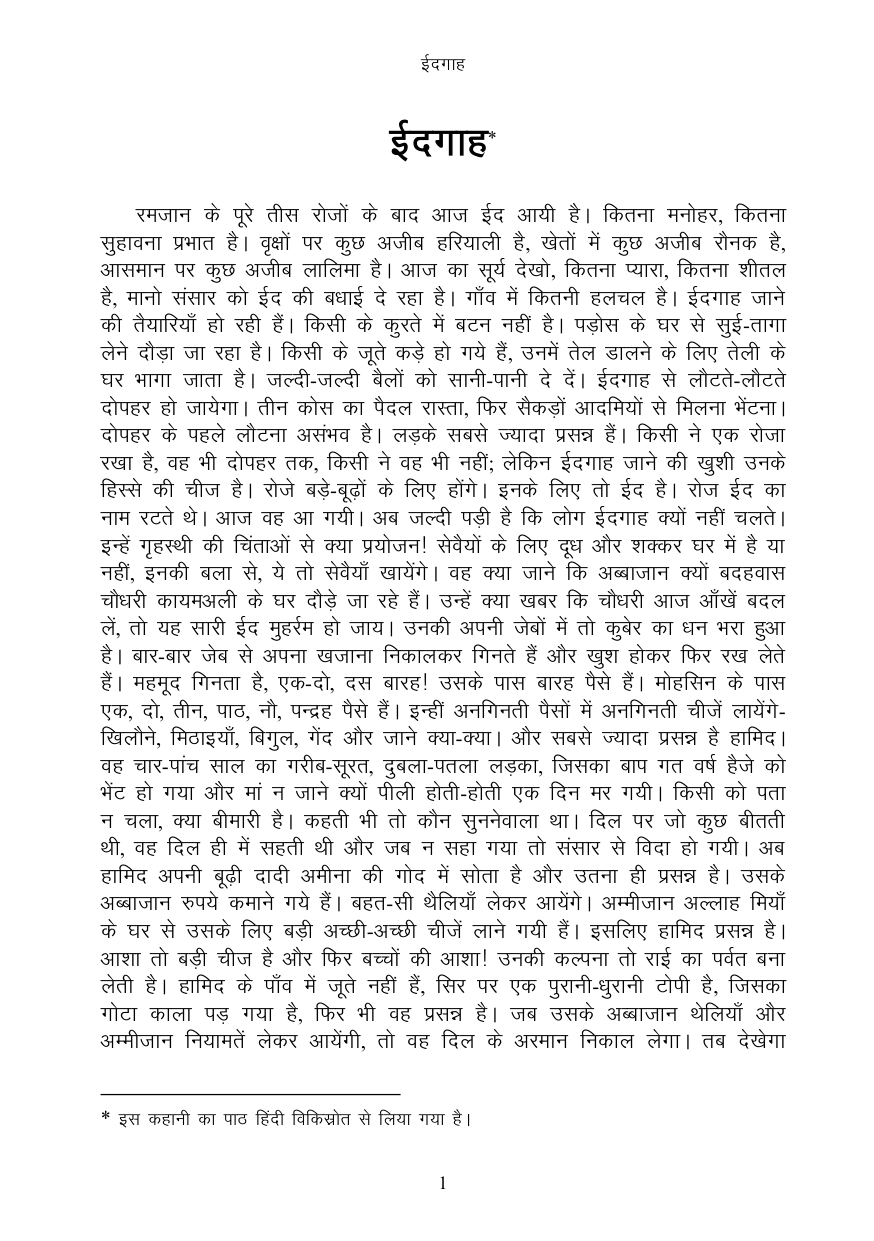
PDF से कॉपी करने पर क्या मिलता है
jetku ds iwjs rhl jkstksa ds ckn vkt Ãn vk;h gSA fdruk euksgj, fdruk lqgkouk izÒkr gSA
IndicPDF ने क्या लिखा (यूनिकोड)
रमजान के पूरे तीस रोजों के बाद आज ईद आयी है। कितना मनोहर, कितना सुहावना प्रभात है।
मूल पाठ से मिलान
99.979%
अक्षर मेल खाते हैं (23,985 में 5 अंतर)
99.897%
शब्द मेल खाते हैं (4,866 में से 5 अलग)
यह डेमो फ़ाइल हमने ख़ुद छापी है: कृतिदेव के बाइट IndicPDF ने लिखे और IndicPDF ने ही वापस पढ़े, दोनों बार एक ही फ़ॉन्ट तालिका से। इसलिए उस तालिका की कोई ग़लती इस आँकड़े में नहीं दिखेगी। नमूना 2 एक असली दस्तावेज़ है, जो हमने नहीं बनाया।
5 अंतर ये हैं: 3 देवनागरी अंक (२, ३) अंग्रेज़ी अंकों में निकले, क्योंकि हमारी छपाई ने उन्हें वैसे ही लिखा था और PDF में 2 और 3 छपे हैं; और मूल पाठ के 2 अदृश्य जोड़ने वाले चिह्न, जो कुछ नहीं दिखाते, हट गए।
नमूना 2: सरकारी राजपत्र में छपा एक अधिनियम
राज्य के राजपत्र में छपे 2016 के एक राज्य अधिनियम के 10 पेज, कृतिदेव में टाइप किए हुए, अंक अंग्रेज़ी फ़ॉन्ट में। भारत में सरकारी अधिनियम दोबारा छापे जा सकते हैं।
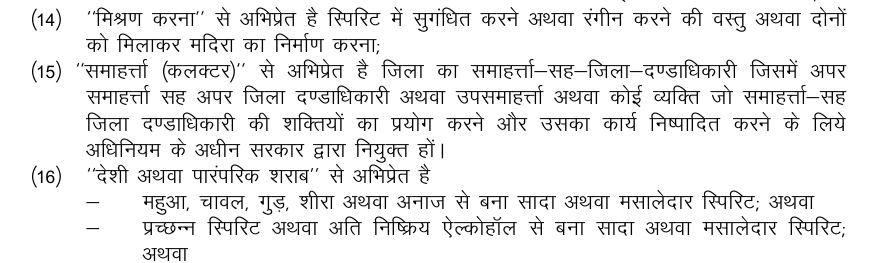
PDF से कॉपी करने पर क्या मिलता है
¼14½ ^^feJ.k djuk** ls vfHkizsr gS fLifjV esa lqxaf/kr djus vFkok jaxhu djus dh oLrq vFkok nksuksa dks feykdj efnjk dk fuekZ.k djuk(
IndicPDF ने क्या लिखा (यूनिकोड)
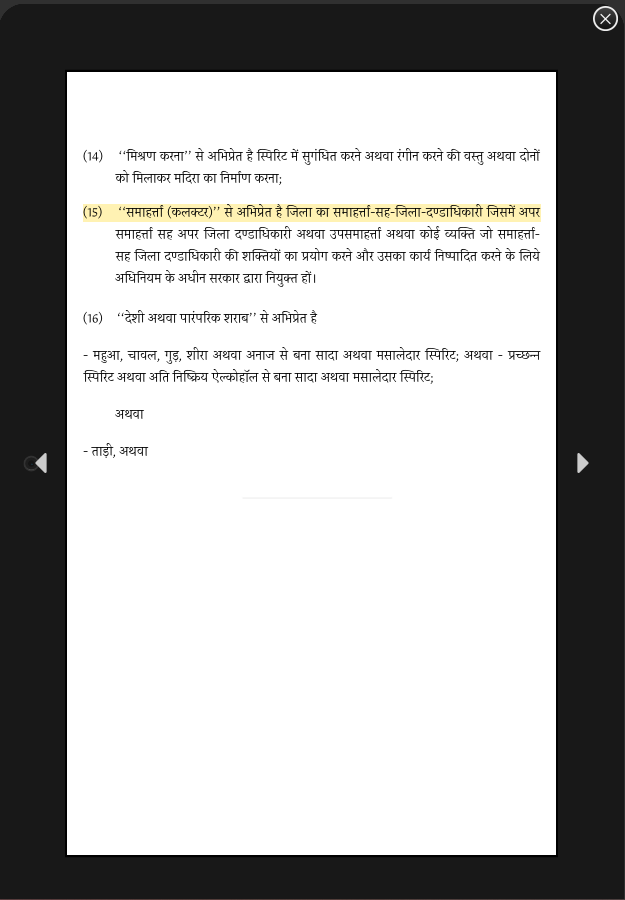
(14) ‘‘मिश्रण करना’’ से अभिप्रेत है स्पिरिट में सुगंधित करने अथवा रंगीन करने की वस्तु अथवा दोनों को मिलाकर मदिरा का निर्माण करना;
दोनों तरफ़ की गिनती
इस दस्तावेज़ का कोई संदर्भ पाठ नहीं है, इसलिए इसका कोई सटीकता आँकड़ा नहीं है। IndicPDF ने PDF में और अपनी लिखी Word फ़ाइल में ये चीज़ें गिनीं:
| अक्षर, पेज-दर-पेज | PDF में 25,674, Word फ़ाइल में 25,674, एक भी नहीं छूटा |
|---|---|
| संख्याएँ | 247 में से 245 हूबहू; बाक़ी 2, 0.5% और 0.05%, Word फ़ाइल में छपे जैसे ही हैं — हमारी जाँच ने % चिह्न को अलग गिना |
| खंड-चिह्न, जैसे (14) | 111 में से 111 |
| धारा संख्याएँ | 29 में से 29 |
पाँच शब्दों में ऐसे चिह्न-क्रम हैं जिन्हें हमारी वर्तनी जाँच प्रूफ़रीडर के लिए चिह्नित करती है। ये गिनतियाँ बताती हैं कि PDF से Word फ़ाइल तक कुछ नहीं छूटा, यह नहीं कि हर अक्षर सही है: यह सिर्फ़ छपे पेजों से मिलान करने वाला पाठक बता सकता है।
EPUB फ़ाइलें
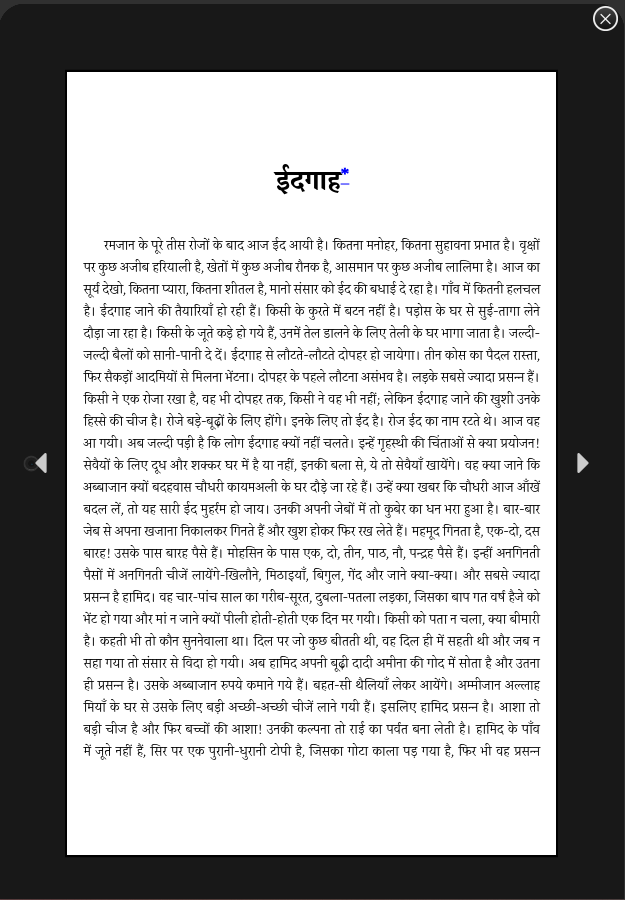
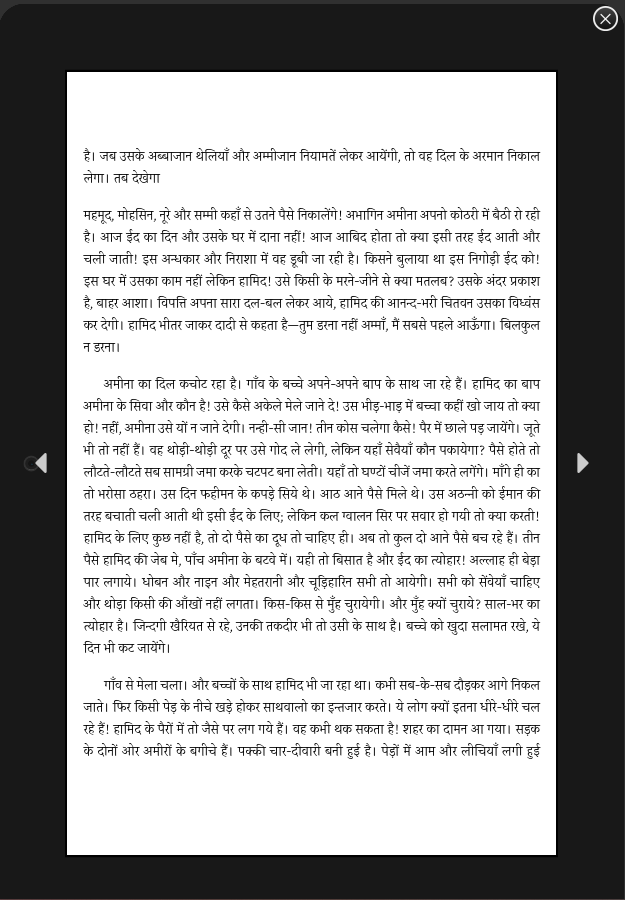
दोनों EPUB, EPUBCheck 5.1 में बिना किसी त्रुटि या चेतावनी के पास होती हैं। Kindle Previewer 3 ने दोनों को 0 त्रुटि और 0 गुणवत्ता समस्या के साथ बदला; नीचे के पेज उसके टैबलेट प्रीव्यू के हैं।
कैसे मापा गया
कहानी की Word फ़ाइल का मिलान उस विकिस्रोत पाठ से किया गया जिससे वह छापी गई थी — यूनिकोड सामान्यीकरण (NFC) के बाद, पंक्ति-विराम और खाली जगहों को छोड़कर। अंतर संपादन के हिसाब से गिने गए: एक ग़लत, छूटा या फ़ालतू अक्षर एक अंतर है, और शब्दों के लिए भी यही। मुखपृष्ठ, पाद-टिप्पणी का चिह्न और ऊपर के शीर्षक नहीं गिने गए, क्योंकि वे कहानी का हिस्सा नहीं हैं। हर अंतर हमारी रिपोर्ट में दर्ज है।
अपनी किताबों पर आज़माइए
बिना खाते के, एक फ़ाइल में 10 पेज तक।