PDF से पन्ने निकालें: संख्या से, या हर पन्ने की भाषा से
करके देखें
आवाज़ नहीं है। कैप्शन बताते हैं कि क्या हो रहा है।
शुरू करने से पहले
- ऐसी PDF जिस पर पासवर्ड का ताला न हो।
- भाषा के हिसाब से पन्ने छाँटने के लिए PDF में असली पाठ होना चाहिए। स्कैन किए पन्ने अपने अलग समूह में रखे जाते हैं।
चरण
1.Split PDF पेज खोलें।
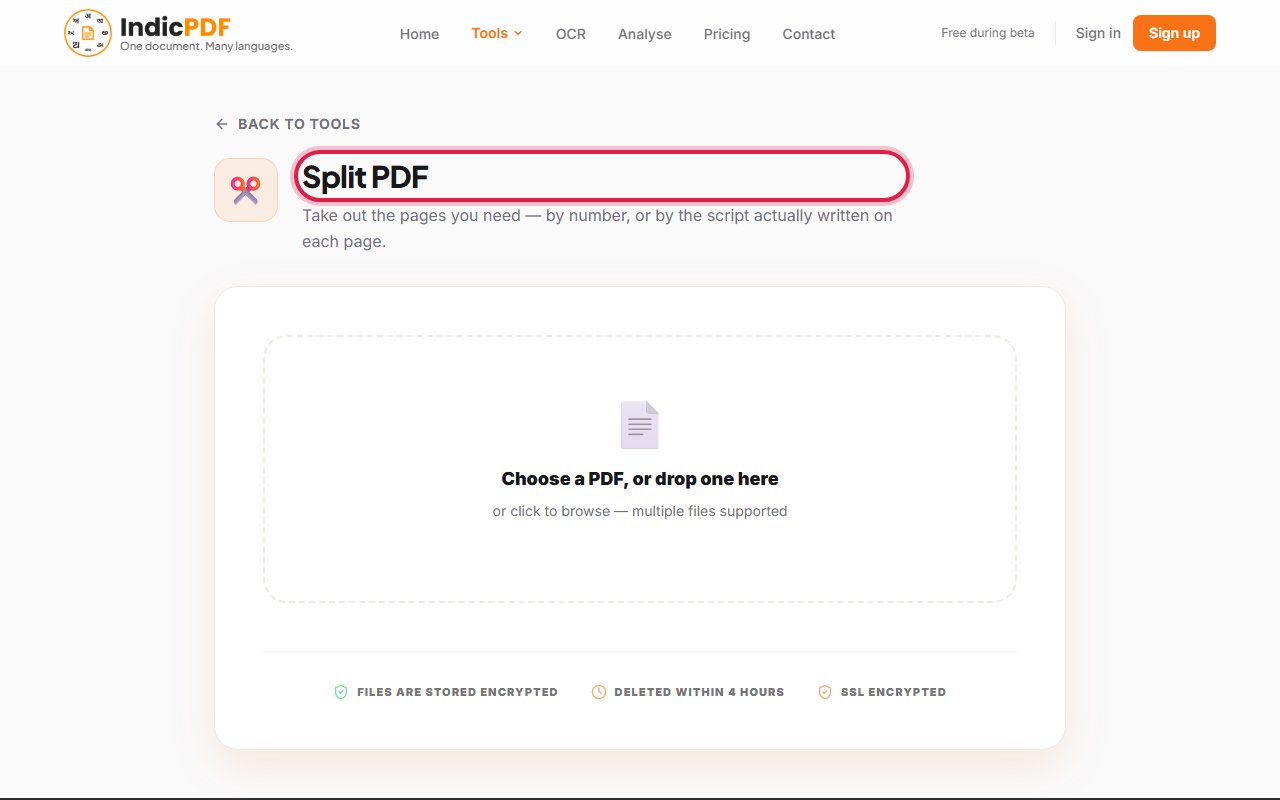
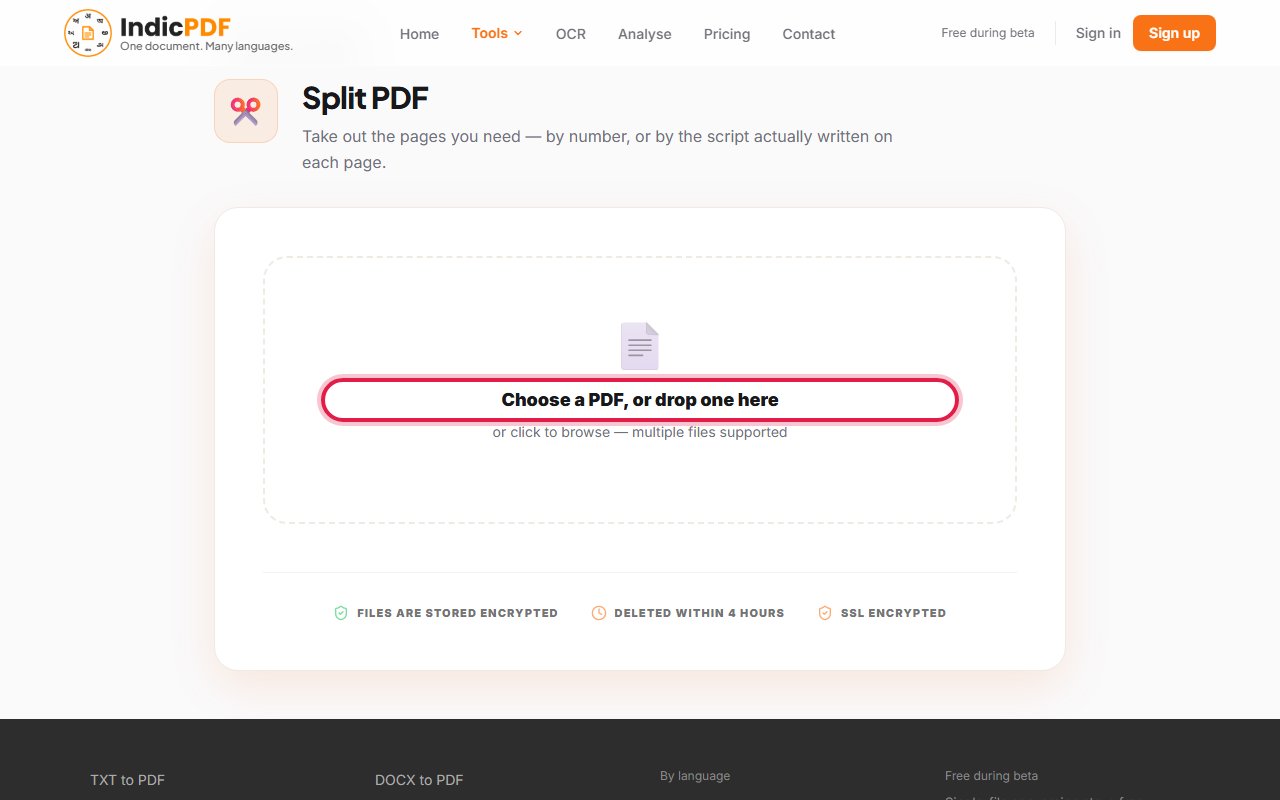
2.Choose a PDF, or drop one here पर क्लिक करें और अपनी PDF चुनें।
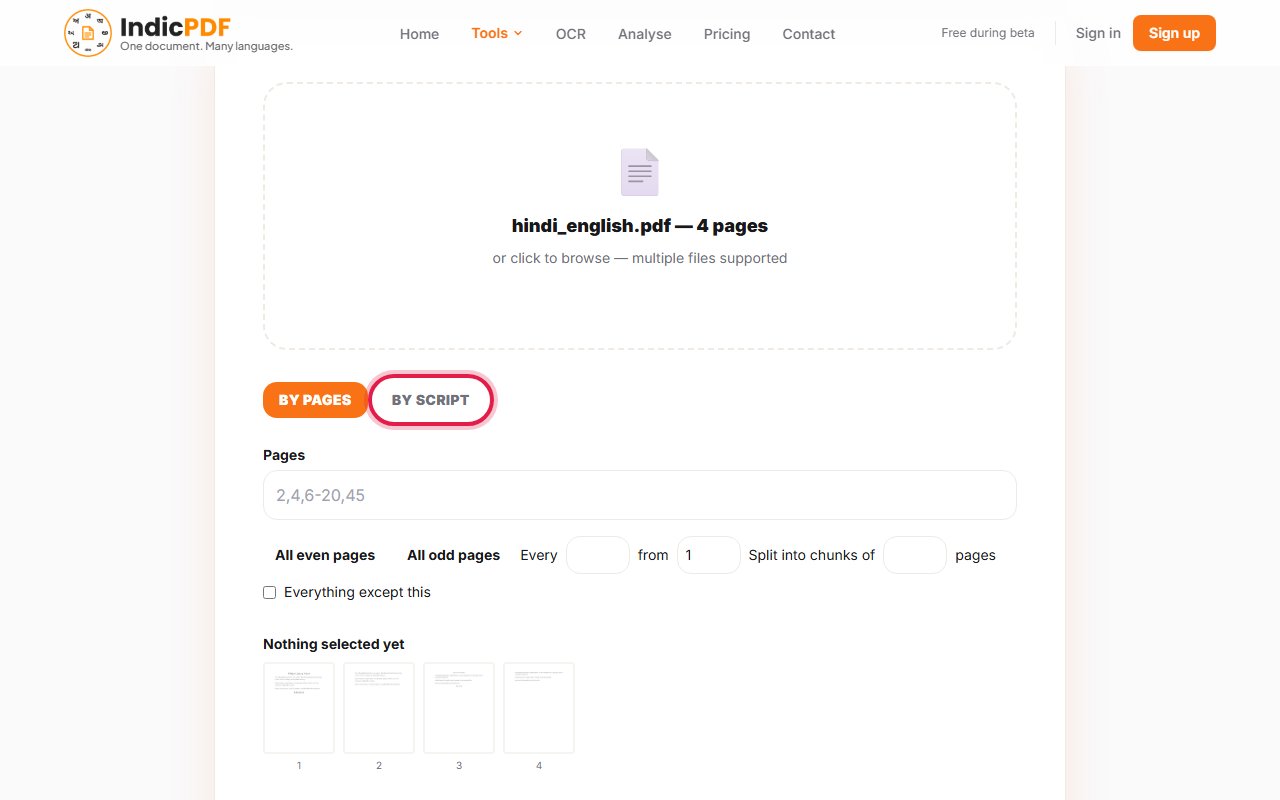
3.पन्नों की संख्या लिखने के लिए By pages चुनें, या पन्नों पर लिखी भाषा के हिसाब से चुनने के लिए By script।
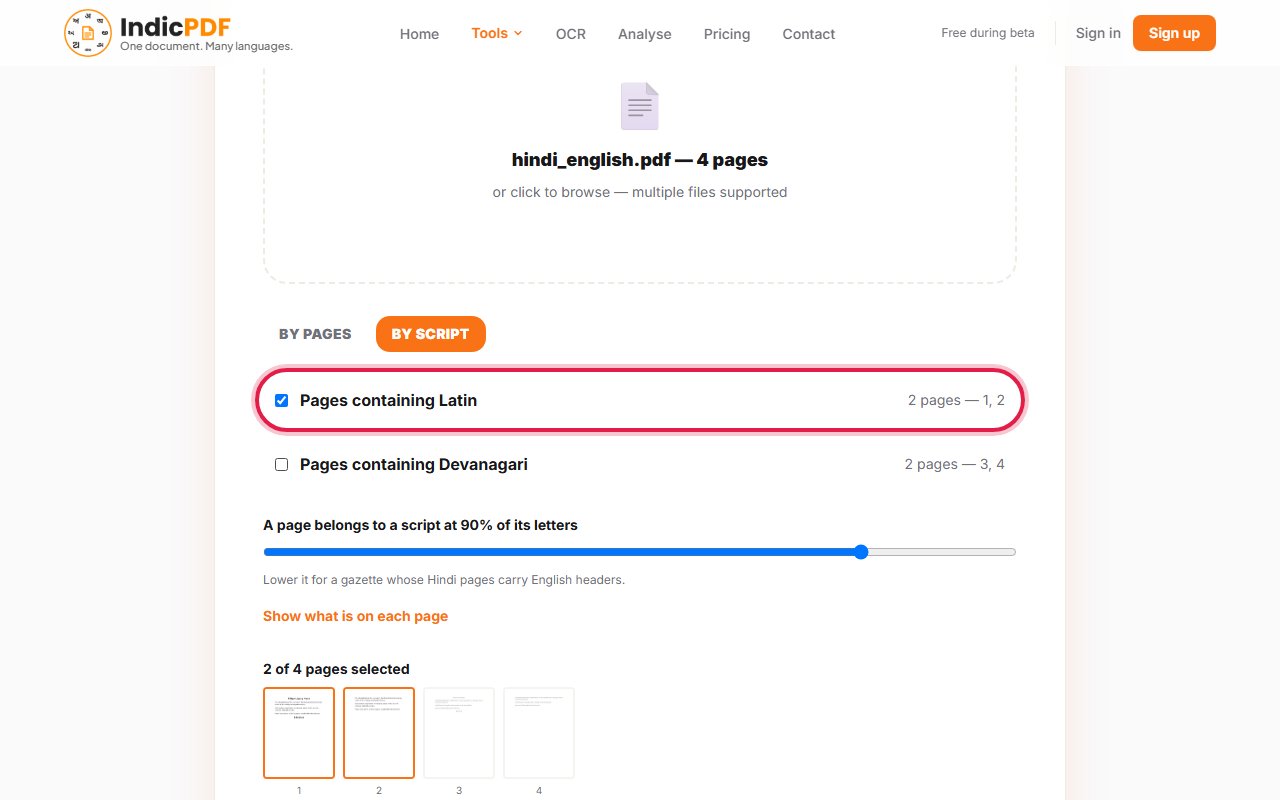
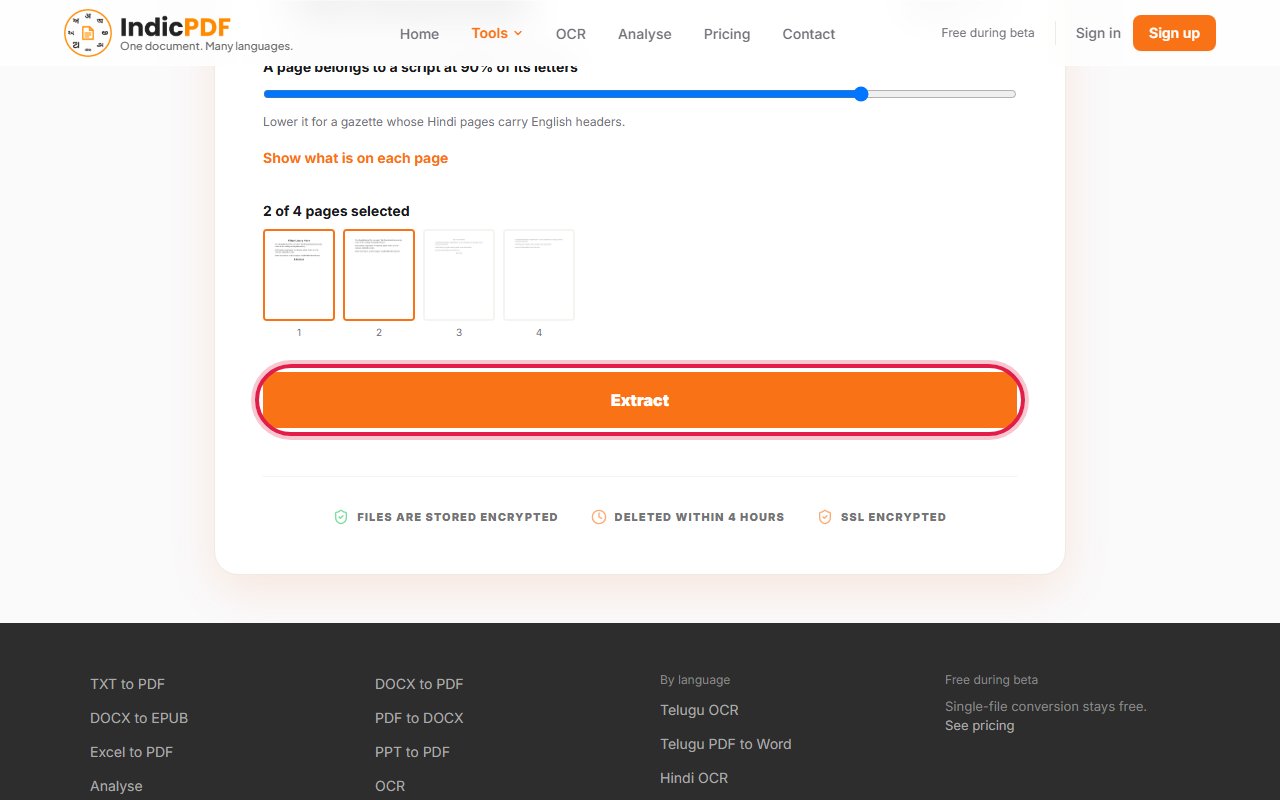
4.पन्ने लिखें या जो समूह चाहिए उस पर टिक लगाएँ। Nothing selected yet वाली पंक्ति चुने गए पन्नों की गिनती में बदल जाती है, और वे पन्ने पट्टी में उभर आते हैं।
5.Extract पर क्लिक करें।
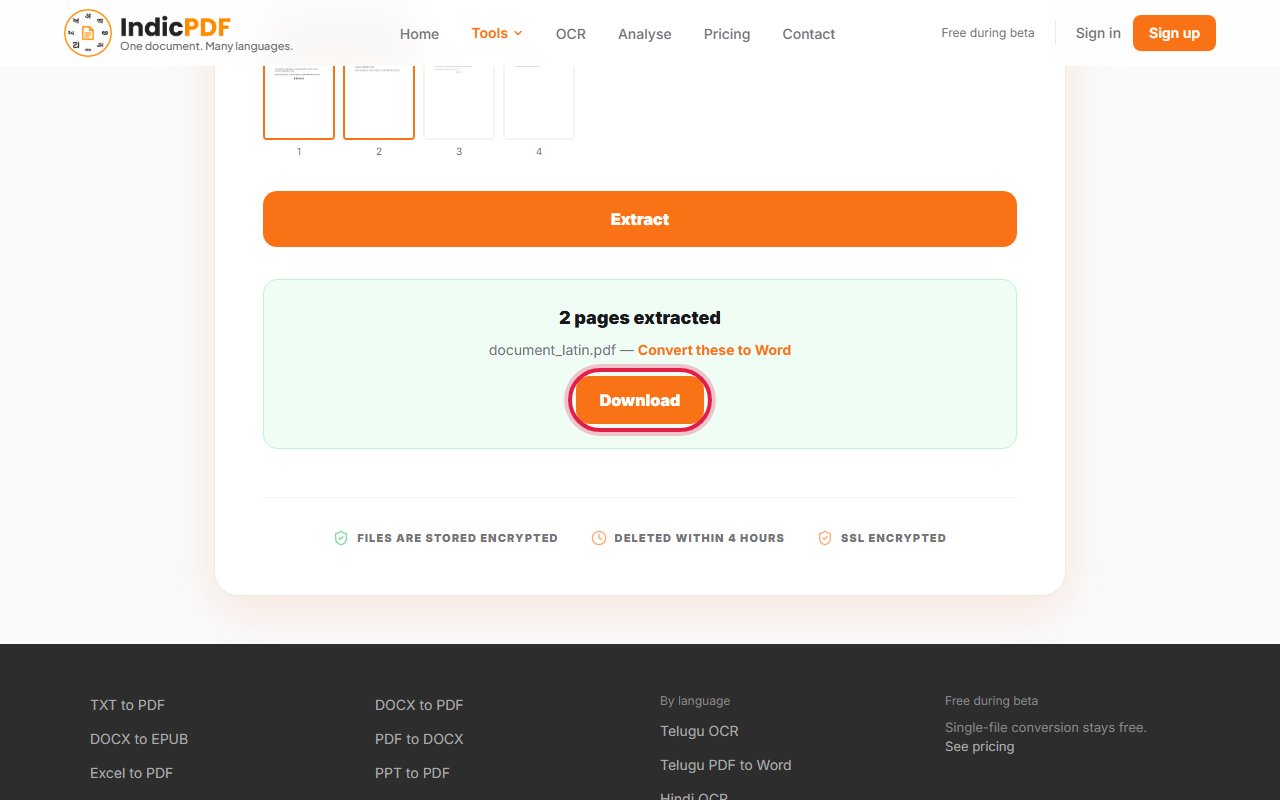
6.Download पर क्लिक करें। उसी PDF से दूसरा समूह भी, दोबारा अपलोड किए बिना, निकाला जा सकता है।


क्या उम्मीद रखें
यह टूल अभी क्या नहीं करता
- स्कैन किए पन्ने भाषा के हिसाब से नहीं छाँटे जा सकते: उनमें पाठ नहीं, तस्वीर होती है। वे अपने अलग समूह में रखे जाते हैं।
- पासवर्ड या कॉपी की रोक से सुरक्षित PDF नहीं ली जाती।
- डिजिटल हस्ताक्षर नहीं बचता: पन्ने निकल आते हैं, पर नई फ़ाइल बिना हस्ताक्षर की होती है।
25 MB तक की फ़ाइलें। आपकी फ़ाइल और नतीजा 4 घंटे के भीतर हटा दिए जाते हैं। साइन-अप की ज़रूरत नहीं।
आम समस्याएँ
कोई पन्ना मिले-जुले समूह में है।
उस पन्ने पर किसी एक लिपि का हिस्सा काफ़ी नहीं है। समूहों के नीचे का स्लाइडर घटाएँ, या पन्ने को उसकी संख्या से चुनें।
मेरे पन्ने बिना पाठ वाले समूह में हैं।
वे पन्ने पाठ की तस्वीरें हैं। उन्हें निकालें और OCR टूल से पढ़वाएँ।
पेज मेरी PDF लेने से मना करता है।
पासवर्ड या कॉपी की रोक से सुरक्षित PDF यहाँ नहीं बाँटी जा सकती। अगर आपको अनुमति है, तो पहले सुरक्षा हटाएँ।
PDF पर डिजिटल हस्ताक्षर थे।
आप फिर भी पन्ने निकाल सकते हैं, पर नई फ़ाइल में हस्ताक्षर नहीं रहता। पेज यह निकालने से पहले बता देता है।